Les fondations du SEO technique : de l’exploration à la croissance mesurable

Un guide orienté ingénierie sur les chemins d’exploration, l’indexation, l’architecture, la performance, les données structurées et les audits SEO.
Le référencement technique est fréquemment présenté comme un ensemble de contrôles isolés : soumettre un plan de site, ajouter des balises canoniques, améliorer la vitesse et réparer les liens rompus. Ces tâches sont importantes, mais la liste de contrôle passe à côté de l’objectif principal. Le référencement technique crée les conditions dans lesquelles un moteur de recherche peut découvrir, interpréter, sélectionner et servir en toute confiance la bonne page. Il s'agit d'une discipline d'ingénierie de l'information qui relie le comportement du serveur, l'architecture du site, les modèles, le contenu et les mesures.
Un site Web techniquement propre ne peut pas compenser un contenu faible ou indifférencié. De même, un contenu de qualité peut rester invisible lorsque les robots d'exploration rencontrent des URL incohérentes, des ressources bloquées, des modèles en double, un rendu peu fiable ou une architecture qui cache des pages importantes. Des performances de recherche durables nécessitent à la fois du sens et de la livraison.
Comprendre le pipeline de recherche
Une page doit passer par plusieurs étapes avant de pouvoir gagner une visibilité utile. Le moteur de recherche découvre une URL via des liens, des plans de site ou des connaissances antérieures. Il récupère la réponse, traite le code HTML et les ressources, décide si la page appartient à son index, interprète sa signification et ses relations, puis l'évalue pour des recherches pertinentes. Un problème au début de cette séquence empêche une optimisation ultérieure de prendre effet.
Ce modèle permet de prioriser les enquêtes. Si une page importante n’est pas découverte, réécrire son titre est prématuré. Si le serveur renvoie des codes d'état incohérents, les données structurées ne sont pas la première préoccupation. Si de nombreuses URL en double sont en compétition pour la sélection, la production de pages plus similaires augmente l'ambiguïté. Le référencement technique doit localiser la première condition cassée et réparer le système qui la produit.
Rendre les réponses du serveur véridiques
Les codes d'état HTTP sont des signaux basiques mais puissants. Une page réussie devrait renvoyer 200. Une ressource déplacée de manière permanente doit être redirigée une fois vers son remplacement final. Une page manquante doit renvoyer 404 ou 410, même si elle affiche une conception personnalisée utile. Renvoyer 200 pour une page d'erreur crée un soft 404 et demande aux moteurs de recherche de déduire l'échec du contenu.
Les chaînes de redirection prennent du temps, compliquent l’exploration et préservent les étapes historiques inutiles. Les liens internes doivent pointer directement vers des destinations canoniques. Choisissez des règles cohérentes pour HTTPS, le nom d'hôte préféré, les barres obliques finales et la casse, puis appliquez-les de manière prévisible. Évitez de rediriger chaque URL manquante vers la page d'accueil ; cela confond les visiteurs et détruit la distinction entre les ressources manquantes et valides.
La fiabilité est également une préoccupation SEO. Des erreurs de base de données intermittentes, des délais d'attente lents et un hébergement surchargé peuvent réduire l'efficacité de l'analyse et la satisfaction des utilisateurs. Surveillez les erreurs du serveur et les temps de réponse à l'aide de journaux réels plutôt que d'attendre qu'un rapport de recherche révèle un modèle des semaines plus tard.
Concevoir des chemins d'exploration grâce à une architecture utile
Un plan du site est une aide à la découverte et ne remplace pas la navigation. Les pages importantes doivent être accessibles via des liens internes ordinaires à partir des parties pertinentes du site. Une hiérarchie claire communique la priorité et le contexte : la page d'accueil présente l'entreprise, les pages de services définissent les offres, les pages de projet démontrent les résultats et les articles approfondissent des sujets spécifiques.
Conservez les pages précieuses avec un nombre raisonnable de clics significatifs. Cela ne nécessite pas un site plat où chaque page apparaît dans la navigation principale. Les liens contextuels sont souvent plus forts car ils expliquent la relation. Un article sur un logiciel de flux de travail interne peut être lié à un service pertinent et à une étude de cas montrant sa mise en œuvre. Le fil d'Ariane expose la hiérarchie aux utilisateurs et aux machines.
Les pages orphelines (URL présentes uniquement dans un plan de site ou un lien externe) manquent de contexte interne et ne reçoivent aucune aide à la navigation. Trouvez-les en comparant les URL connues à partir des plans de site, des analyses, des journaux de serveur et des analyses. Décidez ensuite si vous souhaitez les intégrer, les rediriger, les archiver ou les supprimer. Le but n’est pas de maximiser le nombre d’URL indexées ; il s'agit de maintenir un ensemble cohérent de pages qui méritent d'être trouvées.
Transformez les sujets en système d’information
L'architecture du contenu doit refléter la manière dont l'entreprise peut apporter une valeur distinctive. Des sujets généraux tels que le « développement Web » contiennent de nombreuses intentions. Un système utile sépare les pages commerciales des articles pédagogiques tout en les connectant. Une page de service explique la portée et l’adéquation. Une page de projet fournit des preuves. Un article répond à une question ciblée avec suffisamment de profondeur pour être utile de manière indépendante.
Les groupes de sujets doivent émerger d'une véritable expertise, des questions des clients et des preuves de recherche, et non de la production de dizaines de variantes superficielles de mots clés. Un article faisant autorité peut aborder des formulations étroitement liées lorsque l’intention sous-jacente est la même. Des pages séparées sont justifiées lorsque les visiteurs ont besoin de réponses, de formats ou d'actions sensiblement différents.
Utilisez des titres descriptifs pour exposer la logique d’une page. Le titre principal doit identifier son sujet central. Les titres suivants doivent représenter des sections significatives, et non des tailles de texte décoratives. Cela rend le contenu long plus facile à analyser, améliore l'accessibilité et donne aux systèmes d'analyse une structure stable.
Contrôler la duplication et la canonisation
Le contenu dupliqué est souvent un problème de gestion d'URL plutôt qu'un plagiat. Les paramètres de suivi, les combinaisons de filtres, les vues d'impression, les noms d'hôtes incohérents et les archives CMS peuvent exposer un contenu similaire via plusieurs adresses. Décidez quelle URL doit représenter chaque ressource, créez un lien vers celle-ci de manière cohérente, incluez-la dans le plan du site et utilisez des balises canoniques comme confirmation.
Une balise canonique est un indice, et non une autorisation de maintenir des URL chaotiques. Les moteurs de recherche peuvent l’ignorer en cas de conflit de signaux. Redirigez les vrais doublons lorsque les alternatives n’ont pas de valeur de visiteur indépendant. Gardez les pages canoniques auto-référentielles. Ne canonisez pas les pages sans rapport simplement pour les supprimer des rapports ; utiliser des contrôles d’accès ou d’indexation appropriés en fonction des besoins réels.
Les sites multilingues nécessitent une attention particulière. Chaque version linguistique doit avoir sa propre URL stable et doit déclarer des langues alternatives uniquement lorsque des pages équivalentes existent réellement. L'envoi de chaque remplaçant vers une page d'accueil ou une traduction inexistante crée un réseau trompeur. La langue de la page, le contenu visible, l'URL, les signaux canoniques et hreflang doivent correspondre.
Fournissez efficacement du HTML significatif
Les moteurs de recherche peuvent traiter JavaScript, mais cette capacité ne rend pas toutes les stratégies de rendu également fiables. Les titres, titres, textes, liens et navigation structurés essentiels doivent être présents dans le code HTML initial chaque fois que cela est possible. Les pages rendues par le serveur réduisent la dépendance à l'égard de l'exécution du client et améliorent souvent les performances des visiteurs sur des appareils modestes.
Gardez les contrôles des robots explicites. Une URL bloquée ne peut pas être explorée pour y voir une directive noindex. Utilisez robots.txt principalement pour gérer l'exploration des domaines techniques connus, et non pour supprimer des informations sensibles. Les ressources sensibles nécessitent une authentification ou un refus au niveau du serveur. Les métarobots et X-Robots-Tag contrôlent l'indexation des documents accessibles.
Traitez les Core Web Vitals comme des signaux de produit
Les Core Web Vitals traduisent les aspects de l’expérience en signaux mesurables. La plus grande peinture de contenu reflète la rapidité avec laquelle le contenu visible principal apparaît. L’interaction avec Next Paint reflète la réactivité après la saisie de l’utilisateur. Cumulative Layout Shift reflète la stabilité visuelle. Ils sont importants car les retards et les mouvements interfèrent avec la compréhension et l’action.
Améliorez les causes, pas seulement le score. Optimisez et dimensionnez la plus grande image probable. Préchargez soigneusement les ressources véritablement critiques. Réduisez le travail bloquant le rendu. Réservez des dimensions pour les images et les intégrations. Brisez les longues tâches JavaScript et évitez les scripts tiers qui offrent peu de valeur commerciale. Testez les modèles réels, car une excellente page d’accueil ne prouve pas que les pages d’articles ou de projets fonctionnent aussi bien.
Les tests de laboratoire sont reproductibles et utiles au diagnostic. Les données de terrain montrent ce que les vrais visiteurs ont vécu sur tous les appareils et réseaux. Utilisez les deux. Un test local peut révéler une feuille de style de blocage spécifique, tandis que les données de terrain peuvent montrer qu'un problème affecte uniquement les utilisateurs mobiles ou un modèle particulier.
Utilisez des données structurées pour clarifier, pas pour décorer
Les données structurées expriment des entités et des relations dans un vocabulaire lisible par machine. Pour un portfolio professionnel, les types appropriés peuvent décrire une personne, une organisation, des services, des projets, un fil d'Ariane, des questions fréquemment posées et des articles. Le balisage doit correspondre au contenu visible et doit être généré à partir des mêmes données sources afin qu'il ne devienne pas obsolète.
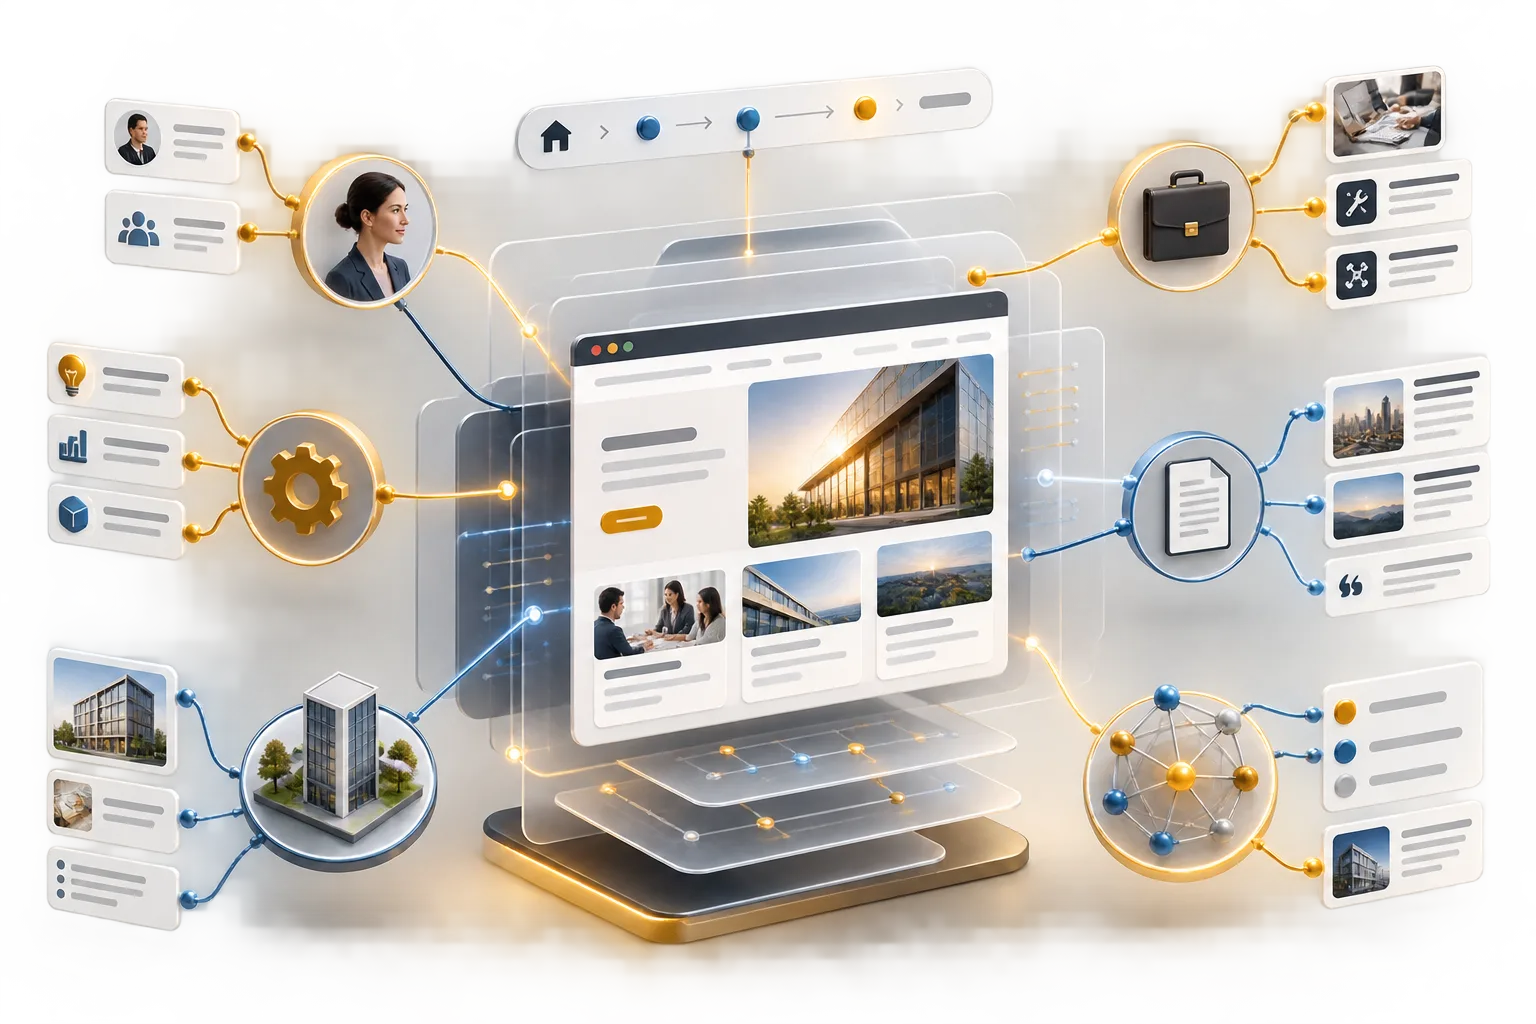
Plus de schéma n’est pas automatiquement meilleur. Marquer chaque section avec des types sans rapport crée du bruit. Choisissez l'entité qui représente le mieux la page, fournissez les propriétés requises et recommandées précises et validez le résultat. Les données structurées peuvent améliorer l’éligibilité aux fonctionnalités de recherche, mais elles ne les garantissent pas et ne remplacent pas le contenu utile.
Concevoir ensemble les médias et les métadonnées
Les images doivent avoir des noms de fichiers descriptifs, des dimensions appropriées, une compression moderne et un texte alternatif qui communique leur objectif. Les images décoratives peuvent utiliser un texte alternatif vide. Évitez d'insérer des mots-clés dans les descriptions. Une image éditoriale significative peut faciliter la compréhension, tandis qu’une grande image générique ne peut que retarder le contenu.
Les titres et les descriptions doivent être uniques, précis et rédigés pour un chercheur évaluant les résultats. Un titre identifie la page et sa promesse distinctive. Une description résume la valeur et peut améliorer la qualité des clics, même si les moteurs de recherche peuvent la réécrire. Open Graph et les métadonnées sociales contrôlent la façon dont les liens apparaissent lorsqu'ils sont partagés. Les URL canoniques doivent être absolues et cohérentes avec les redirections du serveur.
Construire un plan de site qui reflète la réalité
Un plan de site XML doit contenir les URL canoniques et indexables que le site souhaite découvrir. Excluez les brouillons, les redirections, les pages d’erreur et les itinéraires administratifs. Utilisez des dates de modification précises basées sur des changements de contenu significatifs plutôt que de régénérer la date du jour pour chaque URL. Diviser les grands plans de site par type de contenu améliore ainsi la surveillance.
La soumission aux outils de recherche ne force pas l’indexation. Il fournit des informations de découverte et de diagnostic. Comparez les décomptes soumis et indexés, inspectez les exclusions représentatives et recherchez des modèles par modèle. Quelques URL intentionnellement exclues sont normales ; des milliers de variantes inattendues suggèrent une source architecturale.
Audit par éléments probants et impact
Un audit SEO technique utile combine plusieurs vues : une analyse montre la structure accessible, les journaux du serveur montrent ce que les robots demandent réellement, les analyses montrent l'utilisation humaine, les données de la console de recherche montrent les impressions et les commentaires d'indexation, et l'inspection des sources révèle le comportement du modèle. Aucun outil ne fournit à lui seul la vérité complète.
Hiérarchisez les résultats en fonction de l’impact attendu, de la confiance, des efforts et de la dépendance. Une erreur canonique à l’échelle du site affectant chaque page du projet mérite généralement une attention particulière avant les préférences mineures de métadonnées sur un article. Séparez les défauts confirmés des hypothèses. Fournissez des exemples, la portée concernée, le comportement souhaité, le propriétaire de l'implémentation et une méthode de vérification. Un audit doit devenir une feuille de route exécutable plutôt qu’un long inventaire d’avertissements.
Après la mise en œuvre, réanalysez les modèles concernés, inspectez directement les réponses, validez le balisage et surveillez les données de recherche sur une période appropriée. Certains changements sont visibles immédiatement au niveau du serveur tandis que les systèmes de recherche nécessitent du temps pour revisiter et réévaluer les pages. La vérification doit distinguer le succès du déploiement du résultat final de la recherche.
La base pour une visibilité accrue
Le référencement technique a sa plus grande valeur lorsqu’il fait partie du développement plutôt que d’une réparation périodique. La conception des itinéraires, les modèles, les modèles de contenu, les budgets de performances, les règles de redirection, la localisation et les flux de publication créent tous des signaux de recherche. La conception intentionnelle de ces systèmes évite des classes entières de défauts.
L’objectif n’est pas de rendre un site attractif pour un robot au détriment des personnes. Il s’agit de fournir des informations précieuses via une architecture que les deux peuvent comprendre. Des réponses véridiques, des relations claires, des URL stables, des pages rapides, un code HTML accessible, des métadonnées précises et une surveillance fondée sur des preuves créent cette base commune. Une fois qu’elle existe, chaque page véritablement utile a de meilleures chances d’être découverte, interprétée et digne de confiance.